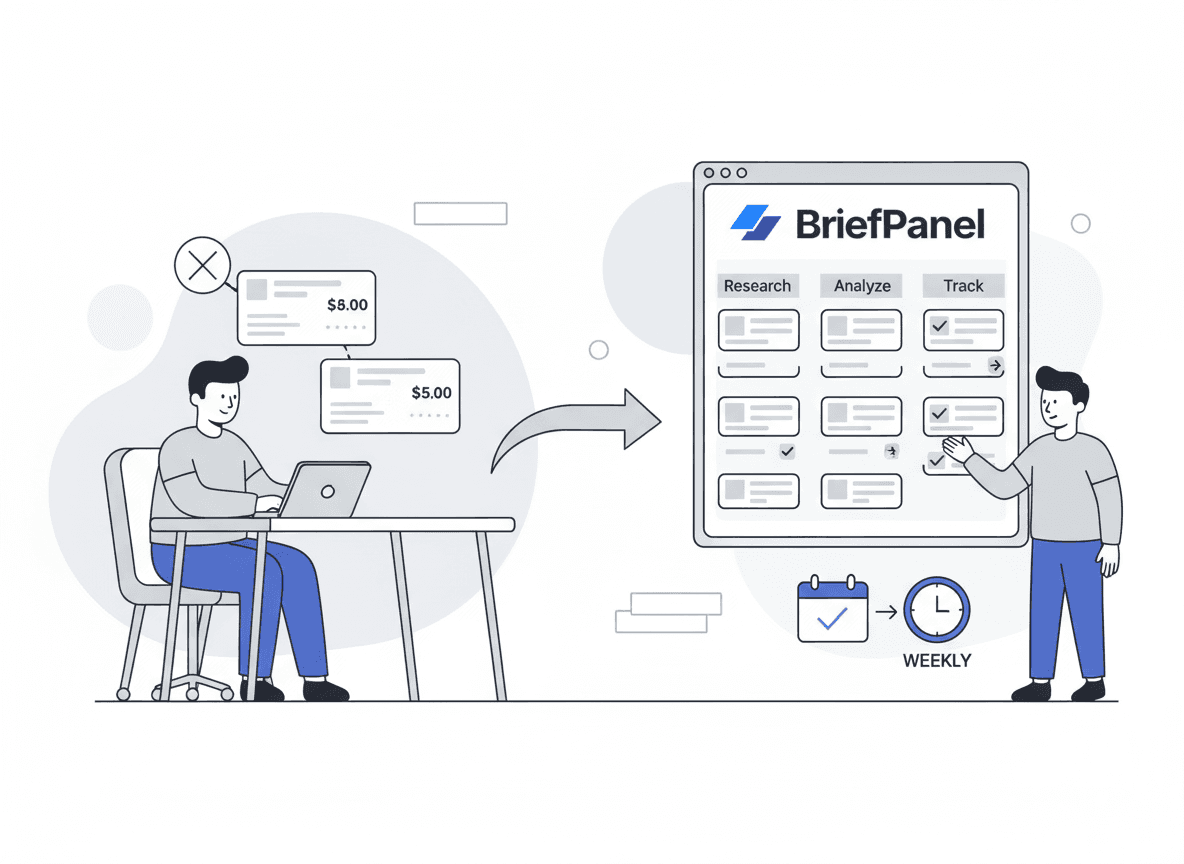
Em algum lugar do seu time existe uma planilha que só existe porque um site não tem API.
Pode ser o catálogo de um fornecedor, os planos de um concorrente ou a lista de avisos que um órgão público publica numa página que ninguém redesenha desde 2016. Alguém copia os números na segunda-feira. Na quarta a planilha já está errada, e ninguém sabe quais linhas mudaram.
Este guia compara as quatro formas realistas de extrair dados de um site sem programar, mostra onde cada uma quebra e explica como o Briefpanel resolve a parte que a maioria das ferramentas ignora: manter os campos tipados e lembrar o que cada um dizia antes.
O que os dados mostram: metade da web tem marcação, e ainda não basta
Dá para imaginar que a web já está estruturada, e em parte está. O projeto Web Data Commons analisa todo ano uma amostra do Common Crawl. Na edição de 2024, encontrou dados estruturados (marcação schema.org em JSON-LD, Microdata ou RDFa) em 51,25% das páginas coletadas, cerca de 1,3 bilhão de 2,4 bilhões. Em 2010, a primeira edição achou isso em apenas 5,7%. O JSON-LD virou o formato mais comum, usado por 70% dos sites que anotam suas páginas (Web Data Commons, janeiro de 2025).
É um avanço de verdade, mas leia as letras miúdas antes de construir em cima disso:
- A coleta cobre domínios populares. Um fornecedor de nicho ou o site de uma prefeitura tem menos chance de estar nesses 51%.
- Quem decide o que marcar é o publicador. A página de um produto pode declarar o preço e deixar de fora o pedido mínimo que importa para você.
- A marcação descreve a página como ela está agora. Não diz quanto custava na quinta passada.
O outro caminho comum, o scraping com seletores CSS ou XPath, tem o próprio problema. A Zyte, fornecedora de scraping, resume no guia para desenvolvedores que seletores costumam falhar quando a estrutura do site muda. Até uma edição pequena no HTML pode fazer um seletor que funcionava não devolver nada. Procurei uma medição independente de quanto tempo a manutenção de scrapers consome e não achei. Os percentuais grandes que circulam vêm de empresas que vendem a alternativa, então trate como marketing.
O que importa é o formato da falha. Um scraper raramente cai. Ele passa a devolver um preço vazio ou o layout do mês passado, e o número errado fica na planilha até alguém confiar nele.
Quatro formas de levar uma página para linhas e colunas
| Abordagem | O que você mantém | Quebra quando | O que você recebe |
|---|---|---|---|
| Copiar e colar | Seu próprio tempo | Você esquece | Uma foto do momento |
| Scraper com seletores | Seletores e agendador | O layout muda | Linhas, se ainda rodar |
| A marcação da própria página | Um parser | O site tira ou altera a marcação | Só valores atuais |
| Ferramenta que resolve itens | Uma descrição curta do que importa | A página deixa de ser pública | Itens, campos e histórico |
1) Copiar e colar
Serve para dez linhas, uma vez. Passou disso, você virou o agendador, e uma pessoa é o cron job menos confiável que você tem.
2) Scraper com seletores
É a ferramenta certa quando você precisa de um conjunto fixo de campos de milhares de páginas, de uma vez, e tem alguém para cuidar do código. Você escreve um seletor por campo, roda num agendador e conserta quando o site muda. Para uma ou duas fontes, o preço é justo. Para trinta, vira um meio período.
3) Ler a marcação da própria página
Se as páginas que você acompanha trazem JSON-LD, ler isso é limpo e barato, e você ignora o layout. A pegadinha é a que vimos acima: você recebe o que o publicador escolheu declarar, do jeito que está hoje, sem memória.
4) Deixar uma ferramenta resolver a página em itens
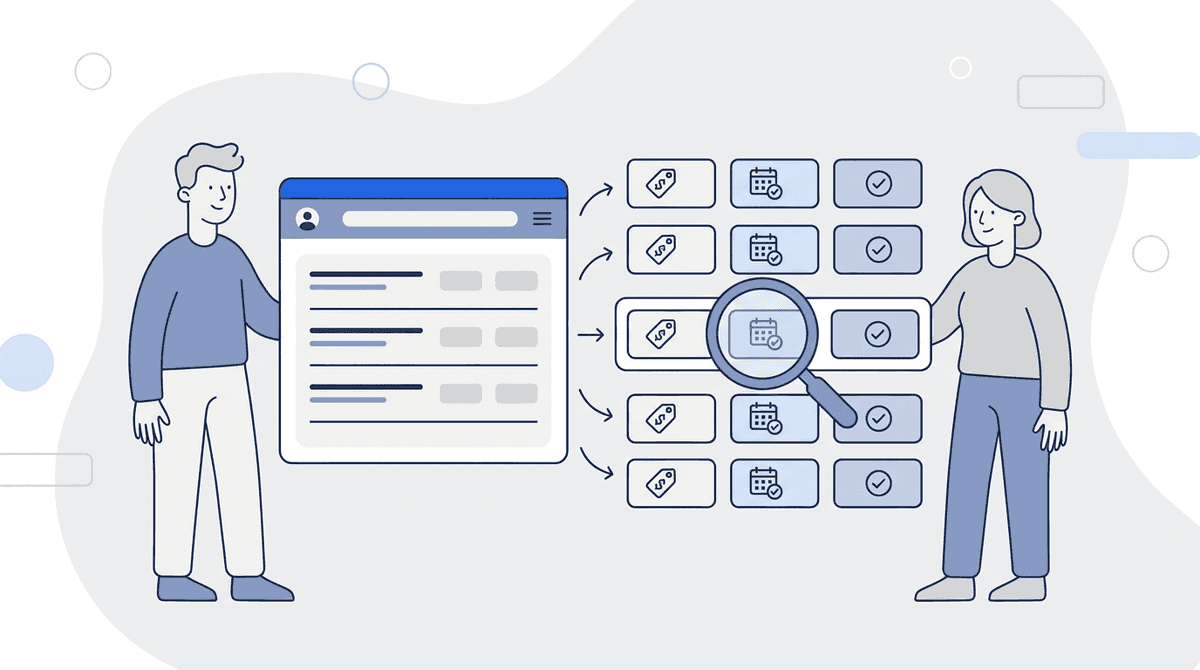
É a abordagem do Briefpanel. Em vez de selecionar campos num layout, ele descobre o que se repete na página (um plano, um anúncio, uma vaga) e trata cada coisa como um item com identidade própria. Os campos vêm do item, não da posição no HTML. Então um redesign que muda o preço da coluna esquerda para a direita não quebra nada.
Como o Briefpanel transforma uma página em dados estruturados
Você adiciona uma URL como fonte. O Briefpanel lê a página e resolve os itens que há nela. Cada item vira uma entrada com um kind aprendido para aquela página, como pricing plan ou job posting, e um histórico tipado.
Veja como uma mudança aparece quando você lê pela API REST (resumido da referência da API; a URL é um exemplo):
{
  "id": "j57e...",
  "at": 1750000000000,
  "updateType": "modified",
  "importance": "material",
  "field": "price",
  "valueChange": {
    "type": "number",
    "previous": 149.9,
    "current": 129.9,
    "unit": "BRL"
  },
  "entry": { "title": "Plano Pro", "kind": "pricing plan" },
  "source": { "url": "https://example.com/pricing" }
}
A ideia toda está nesse objeto: o nome do campo, o valor anterior, o valor atual, a unidade e uma classificação de quanto aquilo importa (critical, material ou minor). Não há nada para comparar a olho.
O que você controla:
- Diga o que importa em linguagem natural. Uma instrução como "guarde preço, status de estoque e pedido mínimo; ignore avaliações e rodapé" define o que é acompanhado. Você não escreve seletores.
- Corrija o que estiver errado. Se um item ou um detalhe faltar, "Corrigir o que é acompanhado" permite descrever o ajuste com suas palavras. "Não mostrar atualizações como esta" ensina a fonte a ficar quieta sobre ruído.
- Listas longas e páginas de detalhe. Quando um catálogo espalha os itens em várias páginas, ou cada item tem uma página com mais detalhes, a verificação pode seguir esses caminhos.
- Sensibilidade. Aumente para páginas em que toda edição conta e diminua para páginas que mudam o tempo todo.
Como tirar os dados do app
Dado estruturado só serve se sair do app. O Briefpanel tem cinco saídas, escolha a que seu time já usa:
- CSV. Exporte os itens atuais de uma fonte pelo menu e abra no Excel ou no Google Sheets.
- Slack ou Discord. Envie cada item novo, alterado ou removido para um canal.
- Webhook assinado. O Briefpanel faz um
POSTde cada atualização de item para um endereço HTTPS seu, assinado com HMAC-SHA256. Entregas que falham são repetidas até cinco vezes, então deduplique pelo id do evento. - API REST. Consulte
GET /v1/updatescom um timestamp emsince, ou leia o histórico completo de uma entrada para um único campo, que é a leitura por trás de um gráfico de preço. O documento OpenAPI é público, então dá para levar ao Postman ou a um gerador de código. Comece pela documentação para desenvolvedores. - Servidor MCP. Conecte um agente no Cursor, no Claude Code ou em outro cliente MCP e faça perguntas sobre seus itens em vez de escrever consultas.
Cada atualização também guarda uma referência ao estado da página de onde veio, então você mostra de onde um número saiu em vez de pedir que alguém confie.
Quanto custa
A cobrança é por uso, com créditos e sem assinatura. Uma verificação gasta um crédito por página lida: a página da fonte, mais cada página seguinte ou página de item que ela abrir, até um teto fixo por verificação. A frequência é por fonte: a cada 30 minutos, a cada hora, a cada 6 horas ou a cada 24 horas. A calculadora de preços mostra os valores atuais.
Quando não é a ferramenta certa
O Briefpanel lê páginas públicas e acompanha como os itens delas mudam ao longo do tempo. Não é um crawler genérico em que você define seu próprio schema JSON e aponta para 50 mil URLs. Para uma extração em massa, feita uma vez, uma plataforma de scraping serve melhor. E se você só quer um número de uma página, uma extensão de navegador sai mais barata.
Como extrair dados de um site sem programar
- Escolha uma página que hoje alimenta uma planilha. Comece com uma fonte só, não com vinte.
- Adicione a URL como fonte e dê a ela uma instrução como a de baixo.
- Escolha uma frequência que combine com o quanto a página realmente muda. Diária basta para a maioria dos catálogos.
- Abra as entradas que ele encontrou e confira com a página. Use "Corrigir o que é acompanhado" no que estiver fora.
- Escolha uma saída: CSV para uma extração pontual, webhook ou API para um fluxo contínuo, Slack para o time que quer ver as mudanças na hora.
Uma instrução que funciona bem para o catálogo de um fornecedor:
"Acompanhe cada produto como um item próprio. Guarde o preço, o preço promocional, o status de estoque, o prazo de entrega e o pedido mínimo. Trate mudança em qualquer um desses como atualização. Ignore avaliações, produtos recomendados, navegação e rodapé."
Releia o primeiro lote de resultados antes de automatizar qualquer coisa adiante. Cinco minutos de conferência agora evitam uma semana com uma coluna errada.
Perguntas frequentes
Dá para extrair dados de um site sem programar?
Dá. Você descreve em palavras o que importa e o Briefpanel resolve os itens, então não há seletores para escrever. Código só aparece na saída, se você quiser ler os dados pela API ou por um webhook.
Dá para levar os dados de um site para o Excel ou o Google Sheets?
Dá. Exporte os itens atuais de uma fonte em CSV pelo menu e abra o arquivo em qualquer um dos dois. Se você quer que a planilha continue atualizada, envie as atualizações por webhook ou pela API REST em vez de exportar na mão de novo.
Web scraping é legal?
Depende do país, dos termos do site e de quais dados você coleta, então isto não é aconselhamento jurídico, e vale consultar um advogado para qualquer dado sensível. O Briefpanel só lê páginas publicamente acessíveis e não faz login em nada.
Funciona em páginas que já têm JSON-LD?
Ele lê a própria página, então funciona com ou sem marcação. Isso ajuda, porque, como mostram os números do Web Data Commons, cerca de metade das páginas coletadas não tem nenhuma, e o que o publicador declara costuma deixar de fora os campos de que você precisa.
Qual a diferença para um monitor que manda um diff da página por e-mail?
Um diff diz que algo na página mudou. Um histórico por item diz qual produto, qual campo e o que havia antes. Para a comparação completa, veja as 10 formas de acompanhar mudanças em sites.
Tenho o histórico de valores, ou só os atuais?
Você tem o histórico a partir do momento em que começa a acompanhar a fonte. O Briefpanel não reconstrói o que uma página dizia antes de você adicioná-la, então adicione cedo as páginas de que vai querer o registro.
Dá para ligar isso ao meu próprio sistema?
Dá: CSV para extrações pontuais, webhook assinado ou API REST para um fluxo contínuo e servidor MCP para agentes. Tudo usa uma única chave de API pessoal, em Configurações → API e integrações.
E páginas atrás de login?
O Briefpanel monitora páginas publicamente acessíveis. Páginas atrás de login ou de paywall não são lidas.
Comece pela planilha que você mais odeia manter
Se uma pessoa do seu time copia a mesma página para uma planilha toda semana, essa página é a sua primeira fonte. Adicione, confira os primeiros resultados com a página e escolha uma saída. Em um dia você sabe se a versão estruturada é melhor que a manual.
Veja como funcionam a API e o servidor MCP →
Guias relacionados
- Top 10 formas de acompanhar mudanças em sites
- Monitorar preço e estoque de fornecedores e concorrentes
- Monitorar preço e packaging de concorrentes
- Monitoramento de docs e changelogs para desenvolvedores