Manter-se em dia com a literatura virou silenciosamente uma das partes mais difíceis de fazer pesquisa.
Não os experimentos. Não a escrita. O simples ato de saber o que foi publicado nesta semana — entre servidores de preprints, sumários de periódicos, anais de conferências, páginas de laboratórios e portais de fomento — agora disputa as mesmas horas de que o seu time precisa para a ciência em si. Perca um preprint relevante e um revisor aponta a sobreposição. Perca uma alteração de edital e você submete aos critérios do ano passado.
Para times de P&D e de inteligência científica, escritórios de pesquisa e laboratórios, esse é um trabalho compartilhado: alguém precisa vigiar as fontes, e todo o resto precisa confiar que nada escapou.
Este guia faz duas coisas. Primeiro, olha para o que os dados realmente mostram sobre volume de publicações e sobrecarga de informação. Depois, apresenta um framework prático de monitoramento de literatura — organizado por camada de fonte e cadência — que um time pode executar manualmente ou automatizar com o BriefPanel, que trata cada artigo, chamada e prazo numa página pública como um item próprio e avisa quando um é novo, alterado ou removido.
O que os dados mostram: a literatura cresce mais rápido do que qualquer um consegue ler
A sensação de "mangueira de incêndio" não é síndrome do impostor. É aritmética.
- Cerca de 3,3 milhões de artigos acadêmicos foram publicados em 2022, ultrapassando 3,4 milhões até 2025. A produção anual subiu de aproximadamente 2 milhões de artigos em 2010 para 3,3 milhões em 2022 — um salto de cerca de 65% em pouco mais de uma década (The Conversation, 2024; WordsRated).
- A produção científica dobra a cada 10–15 anos há mais de um século e cresce cerca de 8–9% ao ano desde 1980. Um estudo de modelagem amplamente citado na Humanities and Social Sciences Communications estima a taxa geral de crescimento perto de 4,1%, com tempo de duplicação de aproximadamente 17 anos (Bornmann, Haunschild & Mutz, Nature HSSC, 2021).
- O STM Report — a referência padrão do setor — constatou que artigos, revisões e anais de conferências cresceram a uma taxa composta de cerca de 4% ao ano de 2014 a 2024, um aumento de 53% na década, com artigos de acesso aberto "gold" crescendo bem mais rápido, em torno de 16% de CAGR (The STM Report, STM Association / Research Consulting).
Os preprints deixaram a cadência ainda mais apertada:
- O arXiv estabeleceu um novo recorde mensal de 24.226 novas submissões em outubro de 2024, acima do recorde anterior de julho de 2024 (21.794), com o ritmo agora em torno de 24.000 artigos por mês. Seu total acumulado passou de 2,59 milhões de submissões no fim de 2024, e a ciência da computação — aprendizado de máquina (cs.LG), visão computacional (cs.CV) e linguística computacional (cs.CL) — domina o fluxo, com mais de 6.000 submissões em um único mês (blog do arXiv, nov 2024; estatísticas de submissões mensais do arXiv).
- O bioRxiv publicou 43.629 preprints em 2024 e o medRxiv publicou 12.863, com o bioRxiv adicionando hoje cerca de 4.000 preprints por mês (bioRxiv, resumo de dados do servidor na Wikipédia).
E isso antes de chegar aos periódicos. O diretório Ulrich's lista mais de 48.000 periódicos acadêmicos ativos e revisados por pares, crescendo alguns por cento ao ano (resumo da Enago sobre dados do STM/Ulrich's). Só o PubMed reúne mais de 40 milhões de citações em 2025 (PubMed, Wikipédia), e o Semantic Scholar indexa mais de 200 milhões de artigos com 2,4 bilhões de links de citação (Semantic Scholar, About).
O custo é medido em tempo. A estimativa frequentemente citada da McKinsey é que profissionais do conhecimento gastam quase 1,8 hora por dia — cerca de 9,3 horas por semana — buscando e reunindo informação (resumo da Cottrill Research sobre a McKinsey). Para pesquisadores, esse tempo é espremido entre bancada, docência e escrita.
Há também um risco indireto. Quando ninguém consegue ler tudo, esforço duplicado e correções perdidas viram algo estrutural. A pesquisa de referência da Nature com 1.576 pesquisadores constatou que mais de 70% tentaram e não conseguiram reproduzir o experimento de outro cientista, e a "pressão para publicar" segue sendo a causa mais citada da crise de reprodutibilidade (Nature, 2016; cultura do "publicar ou perecer", Nature, 2024). Acompanhar erratas, retratações e baselines revisados não é faxina opcional — protege sua seção de métodos.
A conclusão: o problema não é mais encontrar artigos. Ferramentas de descoberta são abundantes. O problema é detectar o que mudou e decidir o que isso significa para você, em uma cadência sustentável.
O kit de ferramentas padrão — e onde ele deixa lacunas
A maioria dos times de pesquisa já roda alguma versão deste conjunto:
Alertas do Google Scholar e buscas salvas do PubMed/NCBI
Excelentes para descoberta por palavra-chave e citações. Mas os alertas do Scholar ficam barulhentos para tópicos com múltiplos termos, e nenhuma das ferramentas avisa o que mudou em uma página que você já acompanha — um preprint revisado, um protocolo atualizado, uma nova cláusula de elegibilidade em um edital.
Feeds RSS e e-mails de sumário de periódicos
Ótimos para sumários estruturados de periódicos. O problema é centralizá-los entre categorias do arXiv, bioRxiv/medRxiv, páginas de chamada de trabalhos de conferências, newsletters de sociedades e portais de fomento — muitos dos quais nem têm um feed limpo.
Ferramentas de descoberta e grafos (Semantic Scholar, Connected Papers, Litmaps)
Brilhantes para mapear a vizinhança de citações ao iniciar um projeto. Mas são ferramentas de "puxar": você vai até elas. Elas não vigiam uma página específica de laboratório ou um boletim de fomento e te avisam quando ele se move.
Posts manuais no Slack do laboratório
Mantêm a equipe alinhada — até alguém ficar ocupado e o hábito se quebrar.
A limitação compartilhada é coleta sem curadoria. Você recebe links, não o contexto, o diff ou o próximo passo.
Um framework de monitoramento de literatura: camadas de fontes e cadência
A solução é parar de tratar toda fonte da mesma forma. Classifique o que o seu time acompanha em camadas e, então, atribua a cada camada uma cadência e um método de monitoramento. Este é o framework que recomendamos.
Camada 1 — Preprints de movimento rápido (verifique diariamente)
É aqui que um time é "furado". Categorias do arXiv, coleções do bioRxiv/medRxiv, ChemRxiv, SSRN — qualquer coisa no seu nicho exato.
- Cadência: diária, ou a cada poucas horas para as uma ou duas categorias em que a velocidade mais importa.
- Método: alertas por palavra-chave para descoberta, mais monitoramento de mudanças nas páginas específicas de categoria e de busca, e nas páginas de resumo dos preprints que você cita (preprints são revisados — v2, v3 — e isso importa).
Camada 2 — Periódicos e anais (revise semanalmente)
Sumários de periódicos, anúncios de edições especiais e anais/listas de aceitos de conferências. O sinal é alto, mas mais lento; ler isso todo dia desperdiça atenção.
- Cadência: verificado a cada 24 h.
- Método: RSS quando disponível; monitoramento de páginas para edições especiais e sites de conferências sem feed.
Camada 3 — Pessoas, laboratórios e código (revise semanalmente)
As páginas de publicações de laboratórios com quem você compete ou colabora, os perfis no Google Scholar de autores-chave e os repositórios GitHub por trás de benchmarks, datasets e bibliotecas de que você depende. Uma nova nota de versão ou um README atualizado discretamente pode mudar seus baselines.
- Cadência: verificado a cada 24 h.
- Método: monitoramento das páginas de laboratórios/perfis; acompanhe ou monitore as páginas de releases dos repositórios.
Camada 4 — Fomento, políticas e infraestrutura (revise semanalmente)
Páginas de financiadores como CNPq, FAPESP, CAPES, NIH, NSF, ERC e Wellcome; atualizações de políticas de dados abertos e ética; avisos institucionais e de CEP. Mudam raramente, mas cada mudança é de alto risco — um prazo deslocado ou uma nova cláusula de compartilhamento de dados pode decidir a elegibilidade.
- Cadência: verificado a cada 24 h.
- Método: monitoramento de mudanças que nomeia os campos que importam (prazo, elegibilidade, termos de compartilhamento de dados), com uma sensibilidade de atualização mais baixa para que ruído de formatação não chegue até você.
O objetivo das camadas é orçamentar a atenção: gaste as verificações mais frequentes nas poucas fontes em que a velocidade gera vantagem e verifique todo o resto uma vez por dia.
Automatizando o framework com o BriefPanel
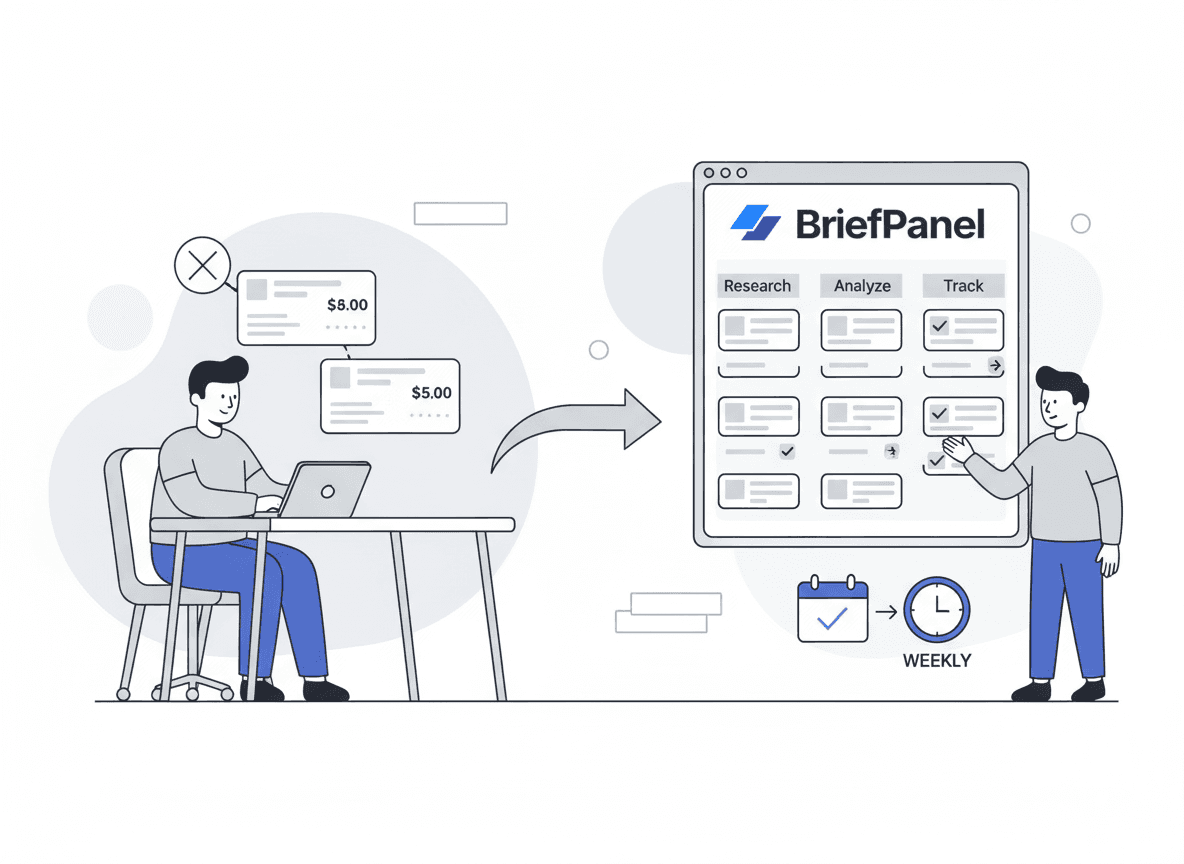
O BriefPanel monitora qualquer página da web publicamente acessível — páginas de categoria de preprints, sumários de periódicos, sites de conferências, páginas de laboratórios, boletins de financiadores, páginas de release do GitHub. Cada página que você adiciona é uma fonte. O BriefPanel encontra os itens nela — cada artigo, chamada e prazo — e acompanha cada um como uma entrada própria, com seu próprio histórico de novo, alterado e removido. Ele se encaixa diretamente no framework por camadas:
- Cada preprint é uma entrada, e seus campos mudam. Um preprint revisado não é uma página que "mudou em algum lugar". É a entrada daquele artigo, com o campo de versão passando de v1 para v2 e os dois valores registrados. O mesmo vale para um novo artigo numa página de chamada de trabalhos ou um prazo que mudou num edital.
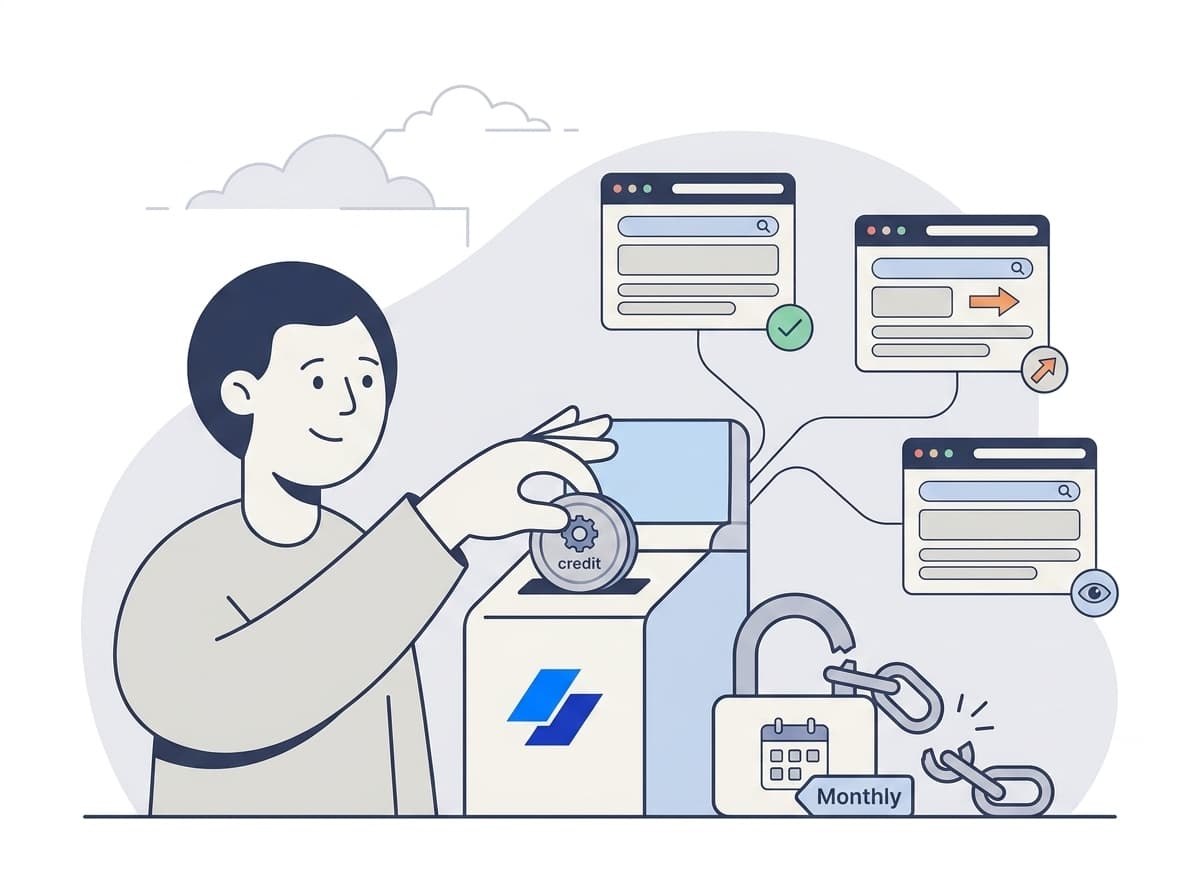
- Páginas de resumo, não só a listagem. Quando os itens de uma fonte têm página própria, uma verificação pode abri-las: de uma listagem do arXiv para a página de resumo de cada artigo, para ler autores, versão e resumo que a listagem não mostra. Cada página lida custa um crédito, até um teto fixo por verificação, então abrir as páginas dos itens custa mais do que ler só a listagem.
- Listas longas. Quando uma listagem divide os artigos em várias páginas, uma verificação pode ler as páginas seguintes da lista também.
- Instruções para relevância. Diga a cada fonte o que acompanhar: "Acompanhe cada novo artigo sobre eficiência de transformers e guarde os datasets de avaliação que ele cita" ou "Acompanhe cada requisito deste edital; trate uma mudança nos termos de compartilhamento de dados ou de sujeitos humanos como uma atualização." Os campos seguem a pergunta de pesquisa do seu time, não um apanhado genérico.
- Cadência por fonte. Cada fonte é verificada a cada 30 min, 1 h, 6 h ou 24 h. Coloque as páginas de preprints da Camada 1 em 6 h ou 24 h, e as outras camadas em 24 h. Verificar com menos frequência é a principal forma de gastar menos créditos.
- Menos ruído com o uso. Em qualquer atualização, "Não mostrar atualizações como esta" ensina àquela fonte o que não importa para o seu time: as atualizações parecidas continuam no histórico, mas não geram mais aviso.
- Sensibilidade da atualização por fonte. Defina a partir de que tamanho uma mudança merece aviso: mais baixa numa página de financiador que recebe edições cosméticas, mais alta onde uma palavra numa cláusula de elegibilidade importa.
- Pergunte ao Assistente. Pergunte coisas como "Quais preprints de cs.CL ganharam nova versão este mês?" ou "Quais prazos de editais mudaram neste trimestre?". Ele responde a partir das suas entradas acompanhadas, cita cada uma e pode desenhar a tendência num gráfico.
- Entrega onde o time já lê. A entrega é definida uma vez para a conta toda: e-mail instantâneo, resumo diário ou semanal, ou os dois, além de notificação push ou um canal do Slack ou Discord por webhook — no idioma do seu time. Um resumo semanal serve a um time cujas fontes mudam devagar; mantenha o e-mail instantâneo ligado se a Camada 1 precisa ser lida no mesmo dia. A API REST, o servidor MCP e os webhooks assinados levam o mesmo histórico para as suas ferramentas.
- Rastreabilidade. Cada entrada registra o que aconteceu — o item e seus valores quando é novo, o campo que mudou com os dois valores quando muda. Cite uma atualização precisa em uma revisão de literatura, um relatório de comitê ou uma seção de trabalhos relacionados. Exporte os itens atuais de uma fonte em CSV para montar uma tabela de literatura; cada atualização, com os valores antes e depois, fica no app e pode ser lida pela API REST e pelo servidor MCP.
Cuida do monitoramento de literatura de um time? Veja como times de pesquisa usam o BriefPanel →
Configuração de 10 minutos para um time de pesquisa
- Liste suas fontes por camada — páginas de categoria de preprints na Camada 1, sumários de periódicos e chamadas de conferências na Camada 2, páginas de laboratórios e repositórios na Camada 3, páginas de financiadores e políticas na Camada 4.
- Adicione as URLs públicas ao BriefPanel. Cole-as uma vez; sem crawler ou script.
- Escreva instruções por fonte para que os campos de cada fonte respondam a uma pergunta real (veja exemplos abaixo).
- Defina a cadência por fonte seguindo as regras das camadas — a cada 6 h ou 24 h para a Camada 1, a cada 24 h para o resto.
- Atribua um responsável para triar cada resumo, e envie as atualizações para o canal do time no Slack por um webhook, para que a thread de "top 3 conclusões" comece a partir da fonte.
Após a primeira semana, o seu time terá um histórico de como a área se moveu — sem abrir quinze favoritos.
Instruções que valem o que pesam
- "Acompanhe cada novo artigo sobre arquiteturas de modelagem de sequência com menos de 1B de parâmetros; guarde os baselines com que ele se compara."
- "Acompanhe cada requisito de política desta página; trate uma mudança na revisão de sujeitos humanos ou na retenção de dados em estudos clínicos como uma atualização."
- "Acompanhe cada novo lançamento de benchmark para ML tabular; guarde se ele cobre domínios de saúde ou finanças."
- "Acompanhe cada chamada aberta com seu prazo e restrições de elegibilidade; guarde se ela exige contrapartida."
- "Acompanhe cada preprint com sua versão, autores e resumo; trate uma nova versão como uma atualização."
Instruções específicas mantêm os campos acompanhados ancorados na sua agenda em vez de um apanhado genérico.
Abordagem tradicional vs. BriefPanel
| Sua necessidade | Abordagem tradicional | Vantagem BriefPanel |
|---|---|---|
| Acompanhar novos preprints em um nicho | Alertas Scholar + leitura manual | Cada preprint uma entrada, com autores, versão e resumo |
| Pegar uma versão revisada de preprint | Releitura por acaso | O campo de versão da entrada vai de v1 para v2, com os dois valores |
| Monitorar lançamentos de benchmark/dataset | GitHub watching + RSS | Cada lançamento uma entrada, com o campo de versão e seus dois valores |
| Manter-se pronto para editais | Favoritar páginas de financiadores | Prazos, elegibilidade e cláusulas como campos, em um resumo |
| Colaborar assincronamente | Threads de chat do laboratório | Atualizações no canal do time no Slack, com link de volta à fonte |
Perguntas frequentes
Como times de pesquisa acompanham novos artigos sem se esgotar? Classifique suas fontes em camadas e orce a atenção. Reserve as verificações mais frequentes para páginas de preprints de movimento rápido no seu nicho exato, e verifique periódicos, páginas de laboratórios e financiadores uma vez por dia. Combine ferramentas de descoberta (Google Scholar, PubMed, Semantic Scholar, Connected Papers) para encontrar artigos com monitoramento de mudanças para detectar o que mudou nas páginas que o seu time já acompanha.
Podemos monitorar arXiv, bioRxiv ou o sumário de um periódico automaticamente? Sim. Qualquer página publicamente acessível — uma categoria do arXiv, uma coleção do bioRxiv, um sumário de periódico, uma lista de aceitos de conferência — pode ser monitorada. O BriefPanel vigia a página e acompanha cada artigo e chamada como uma entrada própria, avisando quando uma é nova, alterada ou removida — então uma v2 de preprint ou uma nova entrada de chamada chega ao seu time sem recarregar manualmente.
E os editais e páginas de fomento? Páginas de financiadores e de políticas mudam raramente, mas com peso. Verifique-as a cada 24 h, com instruções que nomeiam os campos que importam e uma sensibilidade de atualização mais baixa, para ser alertado em um prazo deslocado ou em uma nova cláusula de compartilhamento de dados — não em edições de formatação.
Quanto custa? Não há assinatura: você compra créditos quando precisa. Uma verificação gasta um crédito por página lida: a listagem, cada página seguinte da lista e cada página de resumo que ela abre, até um teto fixo por verificação. As configurações da fonte mostram quanto custa uma verificação dela, e a calculadora de preços mostra os preços atuais.
O BriefPanel substitui o Google Scholar ou o PubMed? Não — ele os complementa. Scholar e PubMed são fortes em descoberta e alertas de citação. O BriefPanel adiciona a camada que falta: vigiar páginas específicas que importam para o seu time e registrar qual campo mudou, e de que valor para que valor.
Um time de P&D distribuído pode compartilhar? Sim. As atualizações podem sair por e-mail, resumo, push ou um webhook do Slack ou Discord, no idioma do seu time, para que equipes em vários locais fiquem alinhadas sobre as mesmas fontes. Os itens também saem do app em CSV, ou pela API REST e pelo servidor MCP.
Obtenha seu primeiro item acompanhado hoje
Times que automatizam o monitoramento finalizam rascunhos mais rápido, evitam trabalho duplicado e identificam oportunidades de colaboração mais cedo. Com a produção crescendo alguns por cento ao ano e servidores de preprints batendo novos recordes, a vantagem fica com quem detecta mudanças cedo — não com quem lê tudo.
O BriefPanel transforma alertas dispersos em atualizações acionáveis, prontas para citação, entregues onde o seu time já trabalha.
Veja o BriefPanel para times de pesquisa → Comece com créditos grátis e recarregue conforme adiciona cobertura.
Guias relacionados
- As 10 melhores formas de rastrear mudanças em sites
- Inteligência competitiva para gerentes de produto
Fontes
- The Conversation — Cientistas relatam milhões de novas descobertas a cada ano (2024)
- WordsRated — Número de artigos acadêmicos publicados por ano
- Bornmann, Haunschild & Mutz — Taxas de crescimento da ciência moderna, Nature Humanities and Social Sciences Communications (2021)
- STM Association / Research Consulting — The STM Report: panorama da publicação científica e acadêmica
- Blog do arXiv — arXiv bate novo recorde de submissões mensais (de novo), nov 2024
- arXiv — Estatísticas de submissões mensais
- bioRxiv — Panorama de dados do servidor (Wikipédia)
- PubMed — Panorama do banco de dados (Wikipédia)
- Semantic Scholar — Sobre / tamanho do corpus
- Enago — Resumo do STM Report 2021, incluindo contagem de periódicos ativos
- Cottrill Research — Resumo dos dados da McKinsey sobre tempo gasto buscando informação
- Nature — 1.500 cientistas abrem o jogo sobre reprodutibilidade (2016)
- Nature — Cultura do "publicar ou perecer" responsabilizada pela crise de reprodutibilidade (2024)